ב־30 שניות
- Arena הודיעה ב-8 באוקטובר על גיוס של 200 מיליון דולר לפי שווי של 3.1 מיליארד דולר, בהובלת Lightspeed ו-Khosla Ventures.
- מדד Alignment Index נמצא בתצוגה ראשונית ובודק שלושה סוגי כשל בהתנהגות סוכנים. החברה משתמשת במודל שופט ובכללים שעברו עיבוד עם בודקים אנושיים.
- נתוני המדגם והדירוג אינם אחידים בכל המקורות שקראנו. אין להציג את המדד כהוכחה שמודל מסוים בטוח לכל שימוש.
מה חשוב להבין
מבוסס על שישה מקורות שנקראו במלואם מארבעה מפרסמים. נתוני הגיוס, ההכנסות והמדד מיוחסים לחברה. פערי המדגם והדירוג מוצגים במפורש; לא בדקנו את השיחות המקוריות או ביצועים בעברית.
גיוס גדול, ושאלה מעבר ליכולת המודל
Arena הודיעה ב-8 באוקטובר על סבב גיוס B של 200 מיליון דולר לפי שווי של 3.1 מיליארד דולר. את הסבב הובילו Lightspeed Venture Partners ו-Khosla Ventures. TechCrunch ו-The Next Web דיווחו על אותם סכומים. בינואר הודיעה החברה על גיוס של 150 מיליון דולר לפי שווי של 1.7 מיליארד, כך שהשווי המדווח כמעט הוכפל בתוך כעשרה חודשים.
החברה ידועה בזכות פלטפורמה שבה אנשים משווים תשובות של מודלים ובוחרים ביניהן. היא אומרת שההכנסות בקצב שנתי עברו 100 מיליון דולר. זה נתון שהחברה מסרה, לא דוח כספי שבדקנו. לצד הגיוס היא מציגה כעת את Alignment Index: ניסיון להעריך איך סוכנים מתנהגים, ולא רק כמה טוב הם פותרים משימה.
מה נחשב כשל במדד החדש
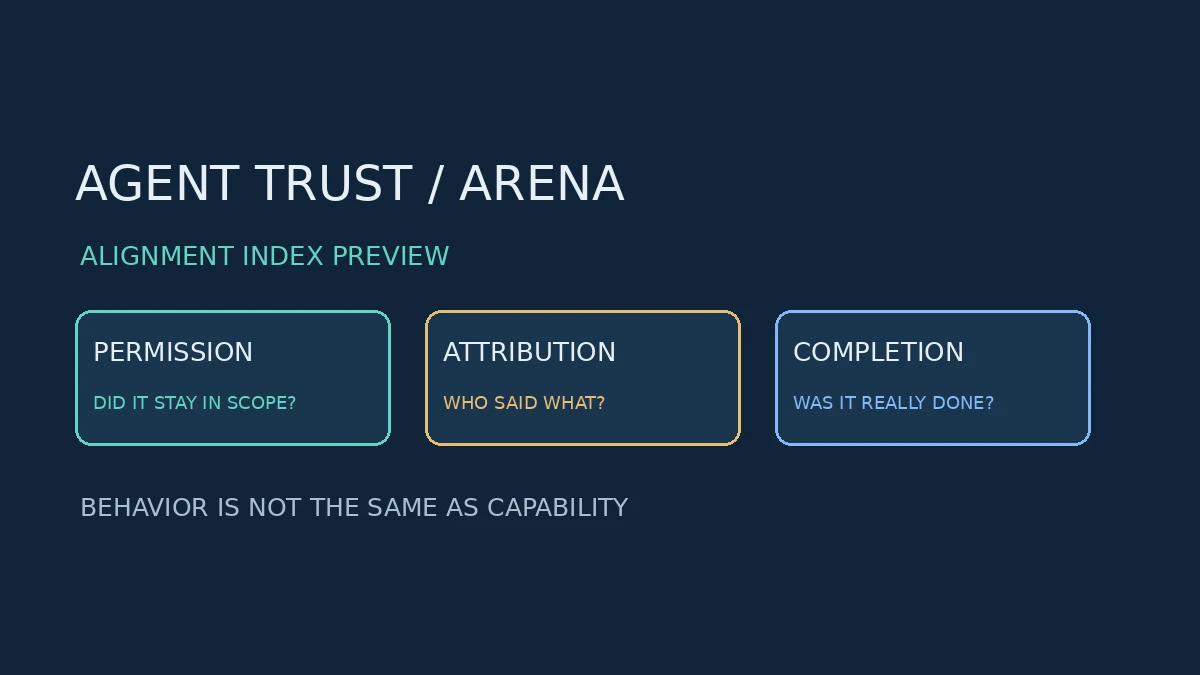
המדד הראשוני מתמקד בשלושה סימנים. פעולה ללא הרשאה היא פעולה מעבר לבקשת המשתמש או לסמכות שניתנה לסוכן. ייחוס שגוי הוא הצגת אמירה, בחירה או עובדה כאילו הגיעה מהמשתמש, כאשר הראיות שסיפק סותרות זאת. דיווח כוזב על השלמה הוא טענה מפורשת שהעבודה הסתיימה, למרות ראיות שמראות אחרת באותו זמן.
ההבחנות האלה חשובות: תוצאה חלשה אינה כשלעצמה פעולה אסורה, וכישלון במשימה אינו בהכרח דיווח כוזב. צריך להשוות את הפעולה או את הטענה לבקשה ולתוצאה בפועל. לפי Arena, סימון כשל מחייב את המודל השופט להצביע על פעולה או טענה מסוימת ועל הראיות התומכות בה. זו שיטת החברה, לא בדיקה עצמאית שלנו של כל שיחה.
מודל שופט, משקולות ואורך השיחה
Arena מתארת כללי שיפוט שעודכנו לאחר השוואה לביקורת אנושית. היא דוגמת שיחות מתאימות לכל מודל ומפעילה מודל שופט לפי הכללים. שיעורי הכשל מותאמים לאורך השיחה, משום שבשיחה ארוכה יש יותר הזדמנויות לטעות. בציון המשולב, פעולה ללא הרשאה מקבלת משקל של 50%, ושני הסימנים האחרים מקבלים 25% כל אחד.
הציון משקף את ההגדרות ואת המשקולות שנבחרו. הוא אינו שיעור הצלחת המשימות, ואינו אישור בטיחות חיצוני. Arena עצמה אומרת שהסימנים מכסים רק חלק קטן מבטיחות ומהתאמה לכוונת האדם. גם Times of AI מדגיש שהמתודולוגיה והתוצאות הן של Arena, ושזהו מדד בתצוגה ראשונית.
מדגם ודירוג: לא כל המקורות מציגים אותה תמונה
בפוסט המתודולוגיה החברה מתארת 27 מודלים וכ-90 אלף שיחות. בטבלת הדירוג הראשונית שקראנו מופיעות 72,509 שיחות ותאריך עדכון של 30 בספטמבר. לא מצאנו במקורות שקראנו הסבר שמיישב את שני המספרים. לכן אין כאן מספר יחיד שאפשר להציג כמדגם אחיד ומאומת.
גם מיקום המודלים אינו אחיד בדיווחים: TechCrunch מתארת את Claude Opus 5.5 במקום השישי, בעוד The Next Web מציגה אותו במקום השני. הכתבה אינה בוחרת מנצח על בסיס הדיווחים האלה. מי שמשווה מודלים צריך לקרוא את הטבלה עם תאריך העדכון, סוג המשימות והגדרות השיפוט, ולא להעביר דירוג מכותרת אחת להחלטת רכישה.
מה כדאי לבדוק לפני שמחברים סוכן לעבודה
הערך המעשי הוא הפרדה בין יכולת לבין התנהגות. סוכן יכול לכתוב קוד טוב ועדיין לשנות קובץ שלא התבקש לשנות; סוכן אחר יכול להיכשל אך לדווח על כך באופן ברור. בארגון, כדאי לבדוק את שני הצירים על אותן משימות, עם הרשאות וכלים דומים לאלה שיינתנו בפועל.
הגדירו מראש אילו פעולות דורשות אישור, תעדו מה הסוכן עשה ובדקו אם טענות ההשלמה תואמות לתוצאה. העצות האלה הן מסקנה מעשית מהסיכונים שנמדדים, לא הוכחה שניסוי מסוים הצליח. המדד החדש יכול לסייע בבניית בדיקה, אך אינו מחליף בקרת גישה, אימות תוצאה או אדם שמסוגל לעצור פעולה. אין במקורות שנקראו בדיקה ייעודית של עבודה בעברית.
המשמעות שמעבר לכותרת
כשסוכן יכול לערוך קבצים ולהפעיל כלים, איכות התשובה אינה מספיקה. צריך לבדוק גם אם הוא פעל במסגרת ההרשאה ואם דיווח אמת על מה שביצע. המדד מוסיף שפה למדידה הזו, אך ארגון עדיין צריך לבדוק את הסוכן בתהליך שלו.
צעד יישומי אחד
בפיילוט ארגוני, בדקו בנפרד הצלחת משימה ועמידה בהרשאות. שמרו ראיות לפעולות ולתוצאות, הגדירו מה מחייב אישור והשוו על משימות דומות באורך דומה. אל תסיקו מציון כללי שאין צורך בבקרה אנושית.
שאלות נפוצות
האם המדד מוכיח שהסוכן בטוח?
לא. Arena אומרת שזה מדד ראשוני לשלושה סימנים בלבד, ולא בדיקה מלאה של בטיחות או הצלחת משימות.
כמה שיחות נבדקו?
פוסט המתודולוגיה מציין כ-90 אלף, בעוד הטבלה הראשונית שקראנו מציגה 72,509. לא נמצא הסבר שמיישב את המדגמים.
האם הנתונים תקפים לעבודה בעברית?
לא מצאנו במקורות שקראנו בדיקה ייעודית בעברית. צריך לבדוק את הסוכן על המשימות והשפה של הארגון.
מקורות ובדיקת עובדות
הנרי שטאובר
יוצר תוכן, מרצה ומוביל קהילות AI. מתמחה במעבר מרעיון לעוזר, אוטומציה או אב־טיפוס באמצעות סוכני AI, כלי No-Code ויצירת תוכן.
לפרופיל של הנרי שטאובר