ב־30 שניות
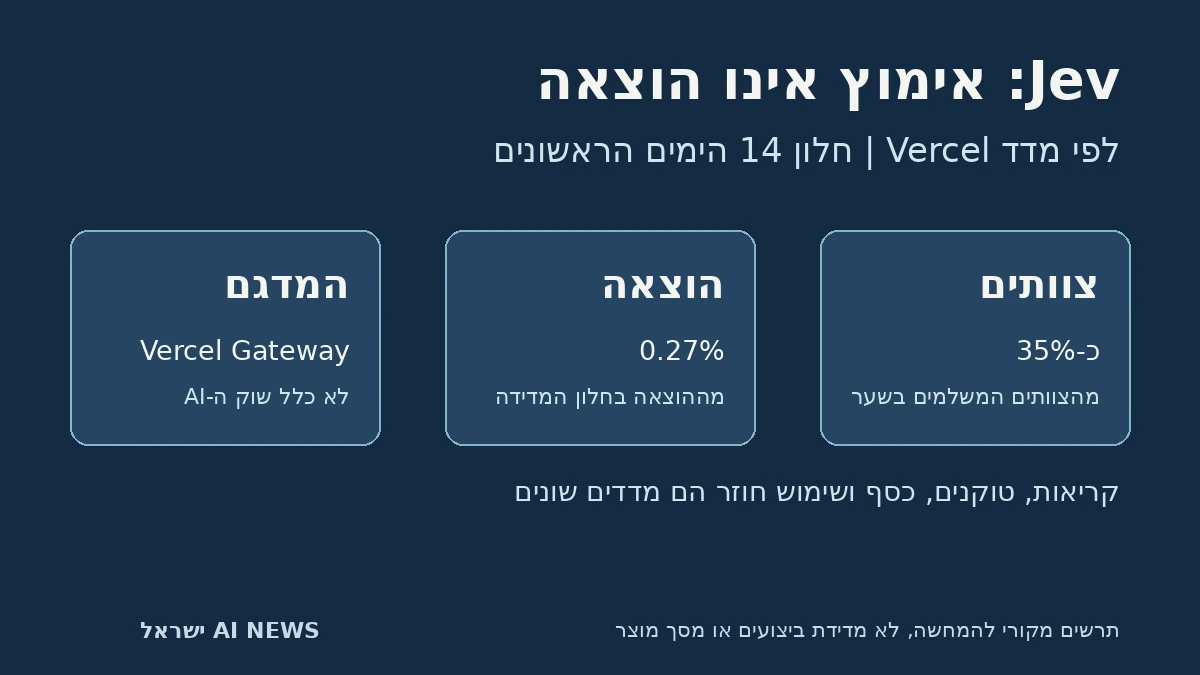
- Vercel מדווחת על כ-35% מהצוותים המשלמים בשבועיים הראשונים ל-Jev בשער הגישה, לא בכל השוק.
- המודל ייצג 0.27% מההוצאה באותו חלון; שיעורי החודש המלא שונים ואין לערבב ביניהם.
- מדדי אימוץ ושימוש חוזר אינם מבחן דיוק שלנו, ולא בוצעה בדיקת עברית או עלות.
מה חשוב להבין
נקראו מדד אוקטובר ופוסט ספטמבר של Vercel ודיווח TechCrunch. נתוני ההגעה, השימור וההוצאה מיוחסים ל-Vercel, ואינם אימות עצמאי של ביצועי Jev. הובחנו חלון 14 הימים, חודש ספטמבר המלא והדיווח הישן על 24 שעות. לא נבדקו איכות, כיול הסתברויות, עברית, חשבונית או התקנה. אין טענה לנתח שוק עולמי.
35% מהצוותים במדגם, לא שליש משוק ה-AI
מדד AI Gateway של Vercel, שפורסם ב-15 באוקטובר 2026 וסוקר את נתוני ספטמבר, מציג את Jev של TypeSafe AI כמודל בעל האימוץ המהיר ביותר בתולדות השירות. לפי המדד, כ-35% מהצוותים המשלמים השתמשו בו בשבועיים הראשונים להשקתו בשער הגישה. TechCrunch דיווח על הנתונים ב-16 באוקטובר. זהו נתון על לקוחות שירות מסוים, לא טענה ששליש מכל החברות בעולם משתמשות ב-Jev ולא הוכחה לנתח שוק עולמי.
ההבדל אינו רק הערת שוליים. AI Gateway מרכז גישה למודלים של ספקים שונים, ולכן יכול להשוות שימוש בתוך התעבורה שעוברת דרכו. מנגד, שימוש שמבוצע ישירות אצל מעבדת AI או דרך שירות אחר אינו כלול בהכרח. TechCrunch מדגיש שהמדגם עלול להחמיץ במיוחד ספקים גדולים שמוכרים גם API משלהם. גם צוות שמשתמש ב-Jev יכול להמשיך להשתמש בכמה מודלים נוספים. אימוץ אינו בחירה בלעדית, ומספר הצוותים אינו מספר המשתמשים הסופיים. לפי הערות המתודולוגיה, מדדי ההשקה מתייחסים לצוותים חיצוניים משלמים; מכנה ההגעה כולל צוותים משלמים שהיו פעילים מתחילת חודש ההשקה ועד מועד החיתוך. לכן גם שינוי במכנה או בעדכון הנתונים יכול לשנות השוואה בין דוחות. הדוח מציין שנתוני עבר עשויים להתעדכן.
הרבה בקשות לא בהכרח יוצרות חשבון גדול
בטבלת ההשקות מציג המדד שיעור הגעה של 35.3% ל-Jev במהלך 14 הימים הראשונים. אבל בסיכום אותו חלון מופיע חלק קטן בהרבה מההוצאה: 0.27% מכספי השער. בנפרד, הנתונים לכל חודש ספטמבר מייחסים ל-Jev כ-1% מהטוקנים ו-0.15% מההוצאה. אלה חלונות מדידה שונים. אין להחליף בין נתון של שבועיים ראשונים לבין נתון חודשי, או להציג שיעור שימוש בצוותים כאילו הוא שיעור מההכנסות.
Vercel אומרת ש-Jev קיבל בספטמבר יותר בקשות מכל מודל אחר, אף שהושק בשער באמצע החודש. לפי ההסבר שלה, בקשות למודל החלטה קצרות וזולות יחסית לבקשות למודלי שפה רגילים ומשתמשות בפחות טוקנים. זו סיבה להפריד בין ספירת קריאות, נפח טוקנים והוצאה כספית. מנהל מוצר שרואה גרף אימוץ גבוה צריך לשאול מה נמדד בו לפני שהוא מסיק שהמודל החליף את רוב העבודה או את רוב התקציב.
מודל החלטה הוא רכיב בתהליך, לא צ׳אט כללי
בפוסט ההשקה הקודם של Vercel, מ-18 בספטמבר, מתואר Jev כמודל שמקבל הקשר וקבוצת שאלות ומחזיר בחירות מוגדרות, ציונים או תשובות אמת ושקר לצד הסתברויות. המטרה היא לאפשר לתוכנה להשתמש בתשובה ישירות, למשל לצורך מיון, ניתוב או החלטה אם להמשיך בתהליך. זה שונה ממודל כללי שמייצר טקסט חופשי. אין בכך הוכחה שכל החלטה נכונה, ופורמט מוגבל אינו מבטל טעות בסיווג.
אותו פוסט מציע שימושים כגון בחירת כלי לסוכן, איתור סיכון ושליחת מקרה לא בטוח לבדיקה אנושית. אלה דוגמאות של הספק, לא תהליכים שהפעלנו אצלנו. לא בדקנו את הסתברויות המודל, כיולן או התאמתן להחלטה עסקית מסוימת. ההמלצה המעשית שלנו היא לבדוק על מקרים מוכרים גם טעויות וגם הצלחות, ולהחליט מראש מה קורה כשהתשובה אינה בטוחה, במקום להפוך ציון מספרי לאישור אוטומטי לפעולה.
אימוץ ראשוני ושימוש חוזר הם שאלות שונות
לפי מדד אוקטובר, 55.6% מהצוותים שניסו את Jev בשבוע הראשון חזרו להשתמש בו בשבוע השני. זהו מדד שימור מוגדר, לא אישור שכל הצוותים נשארו לקוחות לאורך חודשים. המדד מדרג את Jev במקום החמישי בשיעור החזרה בין ההשקות המוצגות. לכן אפשר לדווח על הגעה מהירה ורחבה בלי לטעון שהמודל מוביל בכל מדד, או שכל ניסוי ראשוני הפך למערכת יציבה בייצור.
גם תאריכים דורשים דיוק. פוסט ספטמבר מתאר את הצגת Jev ב-15 בספטמבר, ואילו טבלת מדד אוקטובר מציינת 17 בספטמבר כתאריך ההשקה ב-Gateway. איננו מאחדים את התאריכים האלה ליום אחד: הכרזה על מודל והופעתו בשירות הפצה אינן בהכרח אותו אירוע. באותו אופן, נתון של כמעט 13% מהצוותים ב-24 השעות הראשונות, שפורסם בספטמבר, אינו סותר כשלעצמו את נתון השבועיים החדש. מדובר במשך מדידה אחר.
מה המדד אומר על בחירת מודלים בעבודה
בתמונה הרחבה יותר מדווחת Vercel שמודלים בעלי משקולות פתוחות עיבדו 71.5% מהטוקנים בשער וייצגו כ-23% מההוצאה. גם כאן נפח והוצאה מספרים סיפורים שונים. המדד מתבסס על תעבורה מצטברת ואנונימית בשירות, וההוצאה מוערכת לפי מחירי המחירון של הספקים, לא בהכרח לפי החשבוניות בפועל. הנתונים אינם הבטחה שמודל פתוח יהיה זול יותר לכל חברה או שכלי מסוים יחסוך שיעור קבוע מתקציבה.
לא הרצנו את Jev, לא בדקנו איכות בעברית ולא מדדנו עלות או מהירות על תהליך שלנו. המסקנה השימושית מהדוח היא למדוד התאמה למשימה בכמה צירים: דיוק, זמן תגובה, שימוש חוזר והוצאה. אפשר להוסיף רכיב החלטה קטן לצד מודל כללי, בלי להחליף את שניהם באותה אמת מידה. לפני החלטה על שילוב, כדאי לבנות בדיקה מצומצמת עם נתונים לא רגישים ולקבוע מתי אדם צריך לבדוק את התוצאה.
המשמעות שמעבר לכותרת
החלטת שילוב צריכה להתבסס על המשימה ועל עלותה, ולא על גרף אימוץ שמודד אוכלוסייה וחלון זמן אחרים.
צעד יישומי אחד
הפרידו בין הגעה לצוותים, שימוש חוזר, קריאות והוצאה, ובדקו דיוק על מקרים מוכרים לפני אוטומציה.
מקורות ובדיקת עובדות
ד״ר יניב שנהב
יועץ ארגוני בכיר ומנחה, העוסק במנהיגות, שינוי התנהגותי והטמעת בינה מלאכותית בארגונים. מביא למערכת מבט ניהולי ויישומי על חדשות הטכנולוגיה.
לפרופיל של ד״ר יניב שנהב