ב־30 שניות
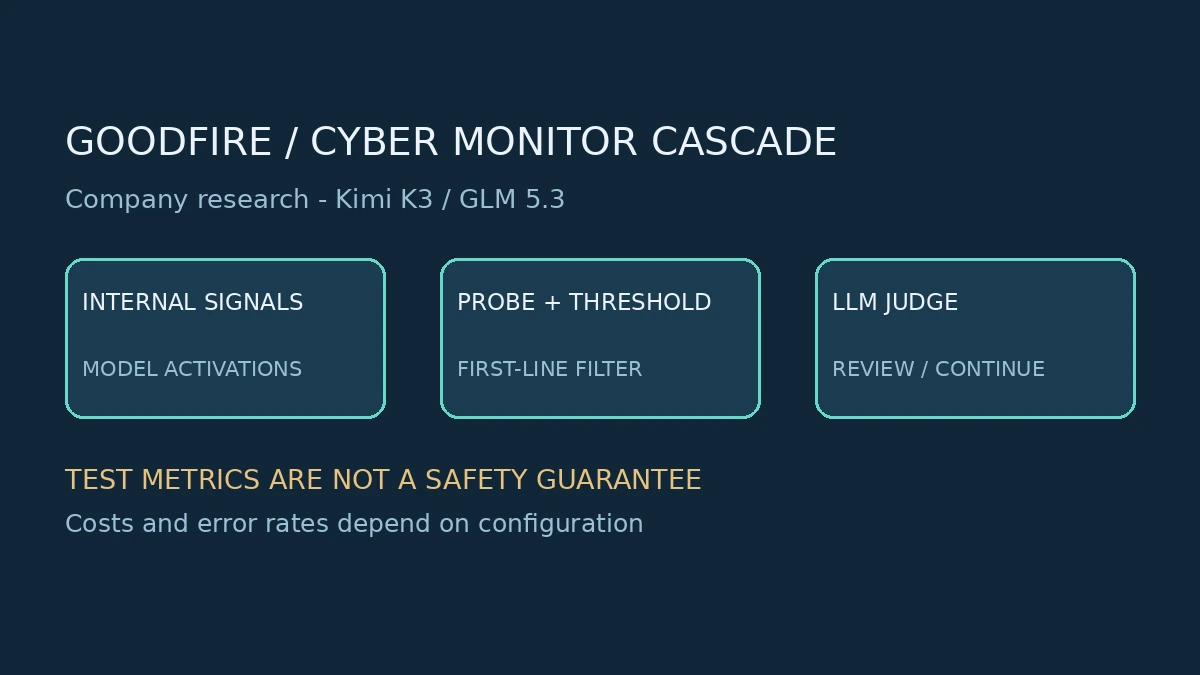
- Goodfire פרסמה ב-8 באוקטובר מערכת ניטור סייבר ל-Kimi K3 ול-GLM 5.3. גלאים קוראים פעילות פנימית של המודל ומעבירים מקרים חשודים למודל שופט.
- במחקר החברה: זיהוי כ-93% מהשיחות המזיקות בנקודה שבה כ-5.5% מהשיחות התקינות נשלחו לבדיקה. עלות השופט שדווחה היא 65 או 185 דולר למיליון תורות, לפי התצורה.
- אלה נתוני החברה, לא בדיקה שערכנו. הדיווח ב-TechCrunch משתמש במדגם ובמספרים אחרים; מבחן התקיפות המובא בפרסום Goodfire היה ראשוני ולא הסתגל למערכת.
מה חשוב להבין
שישה מקורות מחמישה מפרסמים נקראו במלואם. עלויות ודיוק הם נתוני החברה, לא ניסוי שלנו. ציטוט הבדיקה המיוחס ל-FAR.AI נקרא בפרסום Goodfire; לא נמצא ואומת פרסום ישיר של המעריך. פערי המדגמים עם TechCrunch מוצגים בלי להמציא התאמה.
גלאי זול תחילה, שופט יקר רק כשצריך
Goodfire פרסמה ב-8 באוקטובר מחקר על מנטרי סייבר ל-Kimi K3 ול-GLM 5.3, שלדבריה כבר נפרסו בתשתית הסקה. במקום שמודל נוסף יקרא כל תור בשיחה, גלאים קטנים, המכונים probes, קוראים את הפעילות הפנימית של המודל בזמן יצירת הטוקנים. כאשר הציון חוצה סף, המקרה מועבר למודל שופט שיכול לסרב לבקשה או לאפשר המשך.
לפי מדריך Goodfire, הפעילות הפנימית היא מערכים מספריים, לא טקסט של שרשרת מחשבה. הגלאי משתמש בחישובים שהמודל ממילא מבצע. זהו רכיב בתשתית שמגישה את המודל, ולא תוסף שמתקינים לצד כל צ׳אט סגור. TechCrunch דיווחה שהמנטרים זמינים ללקוחות Baseten; אתר Baseten מאשר שיתוף פעולה בתחום תשתיות הבטיחות, אך לא מציג בעמוד שקראנו מחירון למנטר החדש.
המספרים הם נקודות עבודה, לא הבטחה כללית
המחקר הרשמי מתאר מאגר פנימי של כ-2,400 שיחות ומשימות סוכנים, עם יותר מ-60 אלף תורות, ותוויות של Claude Opus 5 כנקודת ייחוס. Goodfire מדווחת על זיהוי כ-93% מהשיחות המזיקות כאשר כ-5.5% מהשיחות התקינות מופנות לבדיקה לפחות פעם אחת. הפניה לבדיקה אינה זהה לחסימת השיחה, והנתון אינו שיעור הצלחה בכל סביבת עבודה.
גם העלות תלויה בתצורה. לפי החברה, עלות מודל השופט למיליון תורות היא 65 דולר בלי הסקה נוספת של השופט ו-185 דולר עם הסקה. ההשוואה לשופט המקביל שקורא כל תור היא חיסכון של בערך פי 49 או פי 29, בהתאמה. זו הערכת חישוב במחקר המבוססת על תעריפי OpenRouter, לא הצעת מחיר ללקוח ולא עלות כוללת שהמערכת אימתה.
למה לא לערבב בין הדיווחים
TechCrunch מציגה מספרים אחרים: כ-51 דולר לניטור כ-1,500 שיחות, זיהוי של 94% מהשיחות המזיקות והעברת 8.7% מהתקינות לבדיקה. Unite.AI ו-Think Facility מתארים את נתוני המחקר הרשמי. אין במקורות שקראנו מיפוי שמאפשר להמיר בין המדגמים והתצורות. לכן לא מחברים את המחיר מהדיווח האחד לדיוק מהאחר.
יש גם הבדל בין תפוקת ההסקה לבין זמן ההמתנה לבדיקה. Goodfire אומרת שהפעלת הגלאים שומרת על תפוקה בתוך רעש המדידה, עם ירידה קטנה מ-2% במבחניה. בה בעת, היא מדווחת שמפל הניטור מוסיף בממוצע 2 או 42 אלפיות שנייה לתור, לפי תצורת השופט. הכותרת של החברה על היעדר השהיה אינה אומרת שכל שרשרת הבדיקה אורכת אפס זמן.
מבחן תקיפות מוגבל, לא אישור שאין פריצות
Goodfire מפרסמת ציטוט שהיא מייחסת ל-FAR.AI על בדיקה ראשונית בת יומיים, עם 140 אסטרטגיות תקיפה קבועות שנבחרו מתוך 1,500. לפי אותו פרסום, לא התקבלה תקיפה אוניברסלית מוצלחת עם המנטר, אך נותרו 18 אינטראקציות שנפרצו. לא מצאנו פרסום ישיר של הבדיקה אצל המעריך; הייחוס והתוצאות כאן הם כפי ש-Goodfire פרסמה, לא אימות עצמאי שלנו.
הבדיקה לא הייתה הסתגלותית: התוקף לא שינה את השיטה בעקבות תגובות המנטר. התוצאות אינן מבטיחות חסימה של תקיפות חדשות, של מודלים אחרים או של שימושים שאינם סייבר. גם גלאי פנימי יכול להחמיץ, וסף רגיש יותר עלול להפריע לעבודה תקינה.
מה לבדוק לפני שמחברים סוכן לעבודה
העניין המעשי הוא אפשרות לפיקוח בזמן אמת לפני קריאה לכלי, במקום גילוי מאוחר בדיעבד. אבל צוות צריך לבדוק אילו נתונים זמינים למנטר, מי מקבל התראות, מה נעצר ואיך משחזרים פעולה תקינה שנקטעה. נתוני המעבדה צריכים להיבחן מול משימות הארגון, כולל ניסיונות עקיפה שמסתגלים למערכת.
Baseten מדגישה שניטור מועיל רק כשהאותות מחוברים להרשאות, לבידוד ולבדיקות לפני הרצת קוד. זו גם ההפרדה החשובה לקוראים: מנטר עשוי לעזור לזהות כוונה מסוכנת, אך אינו מעניק אישור לפעולה, אינו תחליף לגיבוי ואינו מבטל את הצורך בבקרה על פעולות בעלות השלכות.
המשמעות שמעבר לכותרת
פיקוח על סוכן שפועל זמן רב עלול לעלות הרבה אם מודל נוסף קורא כל פעולה. ניטור פנימי עשוי לצמצם את העלות, אך הוא תלוי בגישה לחישובים בתוך המודל ובבדיקת החמצות והתראות שווא. אין להסיק מכך שאפשר לתת לסוכן הרשאות רחבות יותר בלי בקרות.
צעד יישומי אחד
בדקו את התצורה והמודל המדויקים, את הגדרת שיחה מזיקה ואת המחיר של עצירת עבודה תקינה. בקשו נתונים על תקיפות שמסתגלות למנטר ועל שימוש אמיתי. ניטור צריך להצטרף להרשאות מצומצמות ולסביבת הרצה מבודדת, ולא להחליף אותן.
שאלות נפוצות
האם מדובר בתוסף לכל צ׳אט?
לא כך מתואר המוצר. גלאים פנימיים פועלים בתשתית שמגישה את המודל וקוראים את חישוביו. TechCrunch מדווחת על זמינות ללקוחות Baseten; לא אימתנו מחיר או התאמה לכל שירות.
האם אפס תקיפות אוניברסליות אומר שאין פריצות?
לא. בפרסום Goodfire נשארו 18 אינטראקציות שנפרצו, והבדיקה המיוחסת ל-FAR.AI הייתה ראשונית, קבועה ולא הסתגלותית. לא אימתנו אותה מול פרסום ישיר של המעריך.
האם המחיר שפורסם הוא מחירון?
לא. 65 ו-185 דולר למיליון תורות הם אומדני עלות שופט בתצורות המחקר, ולא מחיר כולל לצרכן. TechCrunch מתארת מדגם אחר שאינו ניתן להמרה ישירה.
מקורות ובדיקת עובדות
ד״ר יניב שנהב
יועץ ארגוני בכיר ומנחה, העוסק במנהיגות, שינוי התנהגותי והטמעת בינה מלאכותית בארגונים. מביא למערכת מבט ניהולי ויישומי על חדשות הטכנולוגיה.
לפרופיל של ד״ר יניב שנהב