ב־30 שניות
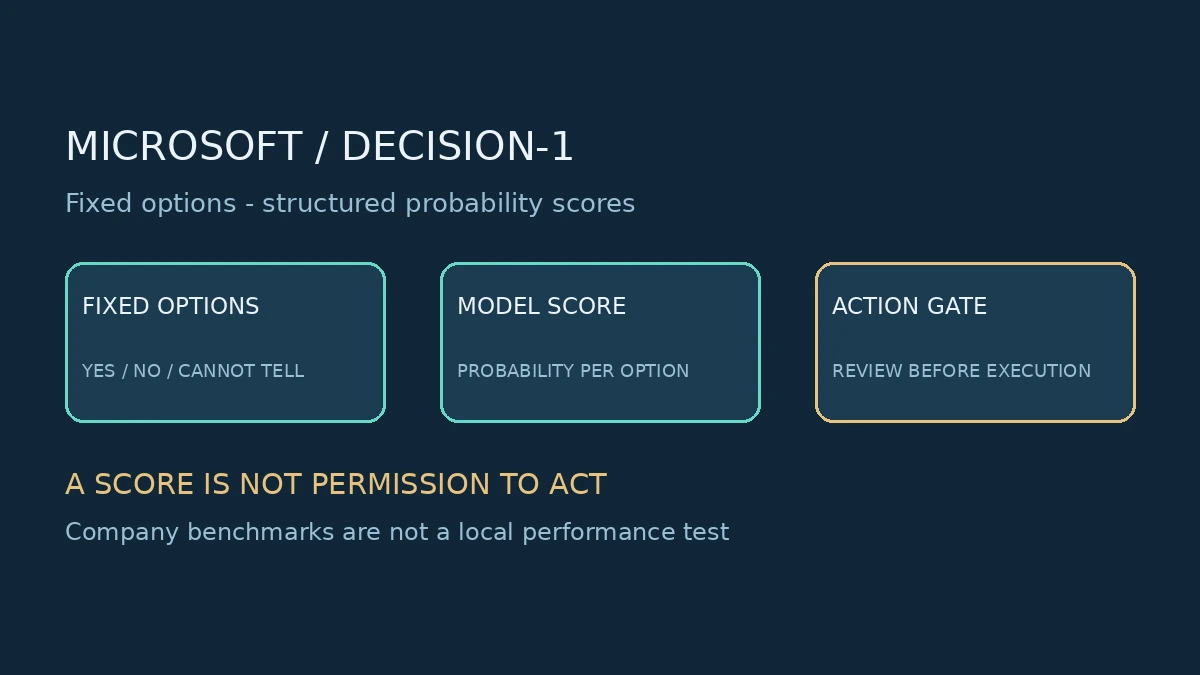
- Microsoft הכריזה ב-9 באוקטובר על Decision-1, מודל שמקבל שאלה ואפשרויות קבועות ומחזיר ציון הסתברות לכל אפשרות, במקום תשובה חופשית.
- המודל זמין בקטלוג Foundry ובעמוד OpenRouter שנבדק. מחיר הקלט המפורסם: 0.042 דולר למיליון טוקנים; פלט ללא חיוב. חלון ההקשר הוא 32,768 טוקנים.
- המודל מיועד למיון ולבדיקת צעדים, לא לשיחה, תרגום או סיכום. כרטיס המודל מזהיר שלא להשתמש בו כמכריע אוטומטי יחיד בהחלטות מהותיות על אנשים.
מה חשוב להבין
חמישה מקורות מארבעה מפרסמים נקראו במלואם. זמינות OpenRouter נבדקה בעמוד המוצר, בלי קריאת API מחשבון לקוח. מדדי הדיוק והמהירות הם נתוני Microsoft ולא שחזור עצמאי. לא נבדקו דיוק בעברית או תנאי חשבון מסוים.
ציון לכל אפשרות במקום פסקה
Microsoft הכריזה ב-9 באוקטובר על Microsoft-Decision-1, מודל ייעודי למיון, ניתוב, תעדוף ובדיקת תשובות או צעדים של סוכני AI. נותנים לו מצב, שאלה ורשימת תשובות מוגדרת, והוא מחזיר ציון הסתברות לכל אפשרות. הוא תומך בשאלות כן או לא, בחירה מרשימה, דירוג ובדיקה לפי מחוון.
לפי כרטיס Foundry, המודל מקבל טקסט ומחזיר JSON, עם חלון הקשר של 32,768 טוקנים. הוא אינו מיועד ליצירת טקסט, שיחה פתוחה, תרגום או סיכום, ואינו מקבל תמונה, קול או וידאו. אין בו הסבר מילולי לנימוקי הציון. לכן זהו רכיב בתוך תוכנה, לא תחליף כללי לצ׳אט.
זמינות ומחיר: לבדוק את מסלול החיבור
המודל מופיע בקטלוג Microsoft Foundry וב-OpenRouter. בהכרזה הרשמית נכתב שהוא זמין בשניהם; TestingCatalog ו-RuntimeWire תיארו בעת פרסומם את OpenRouter כזמינות עתידית. בבדיקתנו עמוד OpenRouter כבר מציג את המודל, ספק Azure ומחיר, אך לא ביצענו קריאת API מחשבון לקוח.
המחיר המפורסם בהכרזה ובעמוד OpenRouter הוא 0.042 דולר למיליון טוקני קלט, ללא חיוב על טוקני פלט. זו עלות קריאת המודל לפי התעריף שפורסם, לא מחיר כולל של סוכן, תשתית או עבודה ארגונית. OpenRouter מציינת גם שהחיבור משתמש ב-Decisions API ולא במסלול chat completions התואם ל-OpenAI; ספריית צ׳אט רגילה אינה מספיקה לבדה.
המהירות היא נתון החברה, לא מבחן שלנו
Microsoft אומרת שבנתה את Decision-1 באימון נוסף של Qwen3.5-9B לצורך ניקוד במעבר יחיד. היא מתכננת לבסס גרסאות נוספות גם על מודלי MAI ו-OpenAI. הבסיס בעל המשקלים הפתוחים אינו הוכחה ש-Microsoft פרסמה את משקלי Decision-1 להורדה.
בהשוואה של החברה על 36 מבחנים וכמעט 150 אלף שאלות, שהמבחנים שלהם הופרדו מהאימון, היא מדווחת על הדיוק הגבוה ביותר בין המודלים שנבדקו. לדבריה, זמן ההשהיה החציוני, P50, היה מהיר פי 35 מ-GPT-6 Sol ופי 4.5 מ-Quyet-1.0-Large. אלה נתוני Microsoft בתנאי בדיקתה, לא הבטחה שכל תהליך יסתיים פי 35 מהר יותר.
החברה מדווחת גם ששינויים בשמונה צורות של בקשות שקולות הפכו את ההחלטה ב-1.3% מהמקרים בממוצע. שינוי ניסוח תיאור האפשרויות והיפוך או ערבוב הסדר לא הפכו החלטות במבחנים האלה. RuntimeWire מציינת שלא פורסמו כל הנתונים ותנאי ההשהיה הדרושים לשחזור עצמאי מלא. אין לנו בדיקת ביצועים עצמאית או בדיקת דיוק בעברית.
הסתברות אינה רשות לבצע
כרטיס המודל מציע אפשרות מפורשת של לא ניתן לדעת כאשר אין מספיק ראיות. הוא מטיל על היישום המחבר אחריות לבחירת התשובות, ספי הביטחון, מסלול ההסלמה, הפיקוח האנושי וההגנות על פעולות ההמשך. ציון גבוה יכול לעזור בניתוב, אך אינו אישור לשלוח הודעה, לשלם או לשנות מערכת.
הכרטיס מזהיר שהמודל לא תוכנן ולא נבדק להיות המכריע האוטומטי היחיד בהחלטות מהותיות על אנשים, ובהן אשראי, תעסוקה, דיור, ביטוח, חינוך, בריאות וזכויות משפטיות. שימוש לסיווג פנימי אינו מבטל את האחריות לתוצאה. זו מגבלת השימוש של כרטיס המודל, לא קביעה משפטית על כל ארגון.
לצוותים בישראל מומלץ להתחיל במשימת מיון מוגדרת ובנתונים שאפשר להשתמש בהם כדין. הכינו דוגמאות בעברית, בדקו מקרים גבוליים ושינוי סדר אפשרויות, וצרו נתיב לחוסר מידע. השוו את התוצאה והעלות מול החלופה הקיימת לפני מתן הרשאות פעולה. זוהי המלצה מערכתית; קטלוג המוצר והמספרים לבדם אינם מוכיחים התאמה לפיילוט שלכם.
המשמעות שמעבר לכותרת
סוכנים צריכים לעיתים למיין בקשה או לבדוק צעד לפני הרצה, ולא לכתוב פסקה. מודל ייעודי יכול לצמצם את עלות הבדיקה, אך ציון הסתברות אינו הרשאה לפעולה ואינו מבטיח התאמה לנתוני הארגון.
צעד יישומי אחד
בפיילוט הגדירו אפשרויות סגורות, כולל חוסר מידע או העברה לבדיקה אנושית. בדקו שינויים בניסוח ובסדר האפשרויות, מדדו טעויות על דוגמאות אמיתיות בעברית והשאירו פעולות בעלות השלכות מאחורי בקרת אישור. אלה המלצות מערכתיות, לא ניסוי שביצענו במודל.
שאלות נפוצות
האם זה מודל לשיחה או לסיכום?
לא. הוא מקבל שאלה סגורה ואפשרויות מוגדרות ומחזיר הסתברויות. כרטיס המודל מחריג שיחה, תרגום וסיכום ואינו מציע הסבר מילולי לציון.
האם אפשר להשתמש בספריית chat completions רגילה?
OpenRouter מציינת שהמודל משתמש ב-Decisions API ולא במסלול הצ׳אט התואם ל-OpenAI. צריך לבדוק את מסלול החיבור המתאים; לא ביצענו קריאת API בחשבון לקוח.
האם פי 35 מהר יותר חל על כל סוכן?
לא. זהו יחס השהיה חציונית ש-Microsoft מדווחת מהשוואת המודלים שלה, ולא מדידה של כל תהליך ארגוני או בדיקת המערכת שלנו.
מקורות ובדיקת עובדות
ד״ר יניב שנהב
יועץ ארגוני בכיר ומנחה, העוסק במנהיגות, שינוי התנהגותי והטמעת בינה מלאכותית בארגונים. מביא למערכת מבט ניהולי ויישומי על חדשות הטכנולוגיה.
לפרופיל של ד״ר יניב שנהב