ב־30 שניות
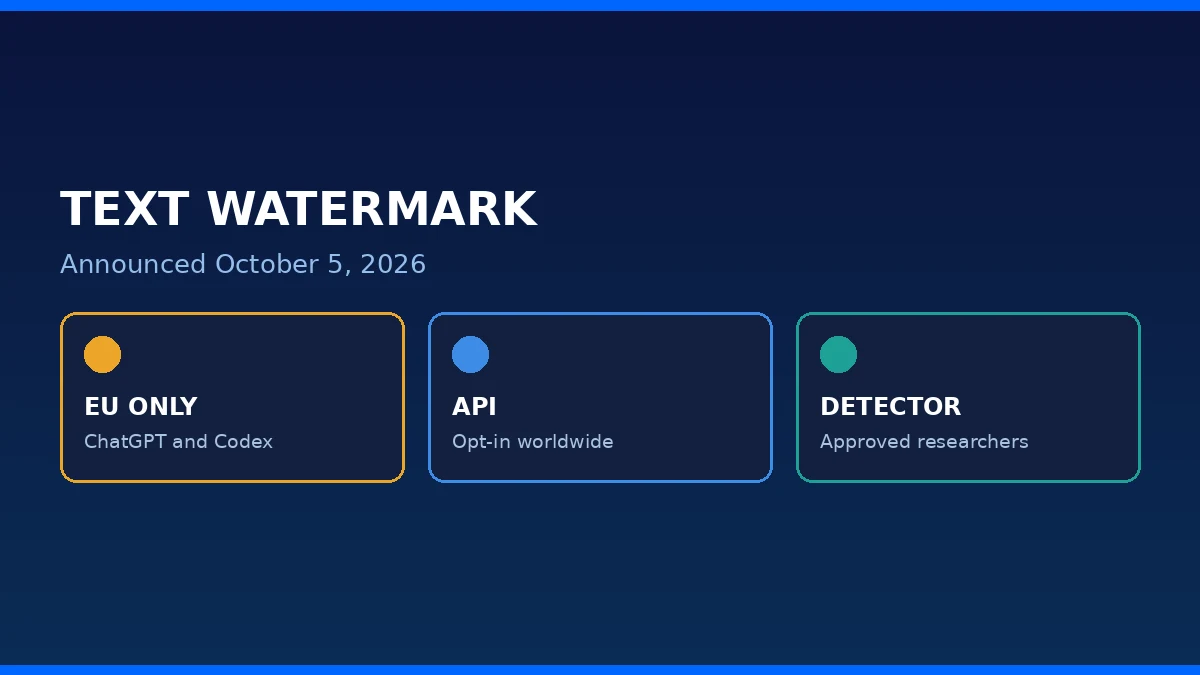
- OpenAI הודיעה ב-5 באוקטובר שבשבועות הקרובים תוסיף סימן מים בלתי נראה לטקסט של ChatGPT ו-Codex בכל התוכניות, באיחוד האירופי בלבד. לקוחות API בכל העולם יכולים להפעיל אותו מיידית בחלק מהמודלים; הוא כבוי כברירת מחדל.
- הטכנולוגיה, textGrain, משנה בעדינות את בחירת המילים של המודל. לפי OpenAI, כלי הזיהוי מוצא את הסימן ב-95% מקטעים של 400 טוקנים, וב-80% מקטעים של 200 טוקנים, בשיעור חיובי שגוי של 1%.
- עריכה פוגעת בזיהוי: החלפת 10% מהמילים במילים נרדפות מורידה את הזיהוי מכ-92% לכ-66%, והחלפת 25% מורידה אותו ל-17%. לכן הגישה לכלי הזיהוי תינתן בשלב ראשון רק לחוקרים וארגוני מומחים שאושרו.
מה חשוב להבין
הכתבה מבוססת על הפוסט הרשמי של OpenAI ועל דיווחי TechCrunch, The Decoder ו-Unite.AI. נתוני הזיהוי והביצועים הם נתוני OpenAI ונבדקו על תשובות באנגלית; לא בדקנו אותם באופן עצמאי.
מה OpenAI הודיעה
בפוסט מ-5 באוקטובר OpenAI מתארת גישה מדורגת לסימון טקסט לפי חוק הבינה המלאכותית של האיחוד האירופי. מהיום, לקוחות API בכל העולם יכולים להפעיל סימן מים לטקסט בחלק מהמודלים, והוא נשאר כבוי כברירת מחדל. בשבועות הקרובים OpenAI תוסיף סימן מים בלתי נראה לטקסט של ChatGPT ו-Codex למשתמשים מתאימים בכל התוכניות, באיחוד האירופי בלבד.
החברה כותבת שהיא לא הופכת סימון טקסט לברירת מחדל גלובלית בהשקה, ושהגישה האזורית נותנת לה מקום ללמוד מהשימוש בפועל. לפי TechCrunch, כללי השקיפות של חוק ה-AI נכנסו לתוקף ב-2 באוגוסט. OpenAI מוסיפה שכלי האימות שלה לתמונות ולאודיו, openai.com/verify ו-Content Provenance API, נשארים פתוחים לציבור.
איך textGrain עובד
לפי OpenAI, textGrain מוסיף אות סטטיסטי בלתי נראה לבחירת המילים של המודל, וכלי הזיהוי בודק אם הוא קיים בקטע. TechCrunch מסבירה שהסימן אינו סמל, והוא נמצא במילים עצמן, ולכן הוא נשאר גם כשמעתיקים ומדביקים את הטקסט. OpenAI אומרת שהסימן אינו מזהה את המשתמש ושלא ראתה שינוי משמעותי בביצועי המודלים כשהוא פועל.
OpenAI פרסמה דוח טכני על השיטה, בשיתוף חוקרים מאוניברסיטת פנסילבניה ומאוניברסיטת ייל, ומתכננת לפרסם את הטכנולוגיה בקוד פתוח. לפי OpenAI, בבדיקות שלה textGrain השתווה לשיטות אחרות שנבדקו, כולל SynthID לטקסט, או עקף אותן. כל נתוני הביצועים כאן הם נתוני החברה.
כמה הזיהוי אמין
לפי OpenAI, בשיעור חיובי שגוי של 1% הכלי זיהה סימן בכ-80% מקטעים של 200 טוקנים ובכ-95% מקטעים של 400 טוקנים בתחומים כמו פסיכולוגיה. בתחומים כמו מתמטיקה, שבהם יש פחות חופש בבחירת מילים, השיעורים נמוכים משמעותית. The Decoder מביא מהגרפים של OpenAI ש-400 טוקנים, בערך 300 מילים, מניבים כ-60% במתמטיקה.
עריכה מחלישה את הסימן: בקטעים של 400 טוקנים, החלפת 10% מהמילים במילים נרדפות מורידה את הזיהוי מכ-92% לכ-66%, והחלפת 25% מורידה אותו ל-17%. הבדיקות נעשו על תשובות באנגלית לשאלות ממאגר ELI5. OpenAI מציינת שקטעים קצרים, תשובות מתמטיות וטקסט מתורגם קשים יותר לזיהוי.
מה סימן מים לא אומר
OpenAI מדגישה שסימן מים הוא אות מוגבל. הוא אינו מודד תרומה אנושית, אינו קובע בעלות או אחריות, אינו מזהה משתמש ואינו מאמת דיוק. היעדר סימן אינו מוכיח כתיבה אנושית: הטקסט יכול להיות קצר מדי, ערוך, מתורגם, ממודל שאינו נתמך, מלפני תחילת הסימון, או מכלי של חברה אחרת.
לפי OpenAI, הסימן יכול לציין שמערכת שלה יצרה או עיבדה חלק מקטע, אבל לא כמה שיקול דעת, עריכה או יצירתיות אנושית נכנסו אליו. זו הסיבה שהחברה כותבת שהיא בוחנת דרכים להבחין בין סיוע של AI לבין כתיבה של AI.
מי יקבל את כלי הזיהוי
OpenAI פתחה הרשמה לגישה לכלי הזיהוי. בשלב הראשון הגישה תינתן רק לחוקרים וארגוני מומחים שיאושרו, בכל מקרה לגופו, לפי קוד השיטות האירופי. הכלי ידווח רק אם זוהה סימן של OpenAI, בלי לזהות משתמש או לחשוף הנחיות ושיחות. OpenAI אומרת שלא תהפוך אותו לציבורי בהשקה בגלל הסיכון להחמצות ולזיהויים שגויים, ושתרחיב את הגישה כשתאמין שאפשר לפרש את התוצאות באחריות, בלי לתת מועד.
לפי The Decoder, Anthropic נוקטת גישה דומה לגבי ה-API לזיהוי של Claude. TechCrunch מציינת שהודעת OpenAI מגיעה כחודשיים אחרי ש-Anthropic הודיעה על סימון טקסט של Claude בכל העולם, צעד שעורר ביקורת של חלק מהמשתמשים.
מה עדיין לא ידוע
OpenAI לא נתנה תאריך מדויק להתחלת הסימון ב-ChatGPT וב-Codex ולא פירטה אילו מודלים ב-API נתמכים. הנתונים שפורסמו הם לתשובות באנגלית, ו-OpenAI לא פירטה איך הזיהוי מתנהג בשפות אחרות. The Decoder מציין שהתוצאות על איכות הפלט אינן קובעות אם הסימון משפיע על איכות הכתיבה.
המשמעות שמעבר לכותרת
החוק האירופי מחייב ספקי AI לסמן טקסט שנוצר באופן שניתן לזיהוי על ידי מכונה, ו-OpenAI מצטרפת ל-Anthropic, שכבר הודיעה על סימון טקסט של Claude. מי שכותב עם ChatGPT או Codex באירופה, או בונה מוצר על ה-API, צריך להבין מה הסימן אומר וממה הוא אינו מעיד: הוא אינו מוכיח מי כתב, וגם היעדרו אינו מוכיח כתיבה אנושית.
צעד יישומי אחד
משתמשי ChatGPT ו-Codex באירופה: הסימן יתווסף בשבועות הקרובים ואינו מזהה אתכם או את השיחה. מפתחים ב-API: אפשר להפעיל סימן מים בחלק מהמודלים, והוא כבוי כברירת מחדל; בדקו איך הוא משתלב בחובות השקיפות של המוצר שלכם. מי שצריך לזהות טקסט: אין כלי ציבורי, והגישה לכלי הזיהוי כרגע רק בבקשה.
שאלות נפוצות
מה OpenAI הודיעה?
שבשבועות הקרובים יתווסף סימן מים בלתי נראה לטקסט של ChatGPT ו-Codex באיחוד האירופי, ושלקוחות API בכל העולם יכולים להפעיל אותו מיידית בחלק מהמודלים.
האם הסימן מוכיח שטקסט נכתב ב-AI?
הוא יכול לציין שמערכת של OpenAI יצרה או עיבדה חלק מקטע. לפי OpenAI, היעדרו אינו מוכיח כתיבה אנושית, וקטעים קצרים או ערוכים קשים לזיהוי.
האם עריכה מסירה את הסימן?
היא מחלישה אותו. לפי OpenAI, החלפת 10% מהמילים מורידה את הזיהוי מכ-92% לכ-66%, והחלפת 25% מורידה אותו ל-17%.
מי יכול להשתמש בכלי הזיהוי?
בשלב ראשון רק חוקרים וארגוני מומחים שאושרו. הכלי אינו ציבורי בהשקה.
האם זה חל מחוץ לאירופה?
ב-ChatGPT וב-Codex הסימון מתוכנן לאיחוד האירופי בלבד. ב-API ההפעלה אופציונלית בכל העולם.
מקורות ובדיקת עובדות
ד״ר יניב שנהב
יועץ ארגוני בכיר ומנחה, העוסק במנהיגות, שינוי התנהגותי והטמעת בינה מלאכותית בארגונים. מביא למערכת מבט ניהולי ויישומי על חדשות הטכנולוגיה.
לפרופיל של ד״ר יניב שנהב