ב־30 שניות
- OpenAI הכריזה ב-26 באוקטובר על GPT‑6.1 Terra, דגם ביניים שמשלב הבנת תמונה, שימוש מדויק במחשב וכתיבה בהירה יותר. לפי OpenAI, המחיר הרגיל ב-API הוא $1 למיליון טוקני קלט ו-$5 למיליון טוקני פלט, חצי ממחיר GPT‑5.6 Terra ו-GPT‑6.1 Sol.
- לפי OpenAI, ב-Agents' Last Exam הדגם קיבל ציון גבוה ב-15 נקודות אחוז מ-GPT‑5.6 Terra בכשליש מהעלות, ושיעור השגיאות במבחן הנחיות מכשילות ירד מ-53.6% ל-16.7% ברמת חשיבה נמוכה. אלה מדידות של OpenAI עצמה.
- הדגם זמין למנויי Plus, Pro, Enterprise ו-Edu ב-ChatGPT Work וב-Codex, וגם ב-Amazon Bedrock, ב-Microsoft Foundry וב-GitHub Copilot. לפי כרטיס המערכת, OpenAI מתייחסת אליו כרמת Critical בסייבר.
מה OpenAI הכריזה
לפי OpenAI, GPT‑6.1 Terra הוא דגם מהיר ויעיל שמשלב הבנה חזותית מפורטת ושימוש מדויק במחשב לצד כתיבה בהירה וטבעית יותר. החברה מציגה אותו כשיפור משמעותי לעומת GPT‑5.6 Terra במשימות שממלאות את יום העבודה, מכתיבת הצעות ועד קריאת שרטוטים טכניים, מילוי טפסים ועריכת וידאו. The Next Web מוסיף שהוא מחליף את GPT‑5.6 Terra ויושב באמצע סדרת הדגמים, מתחת ל-Sol ול-Astra ומעל ל-Luna.
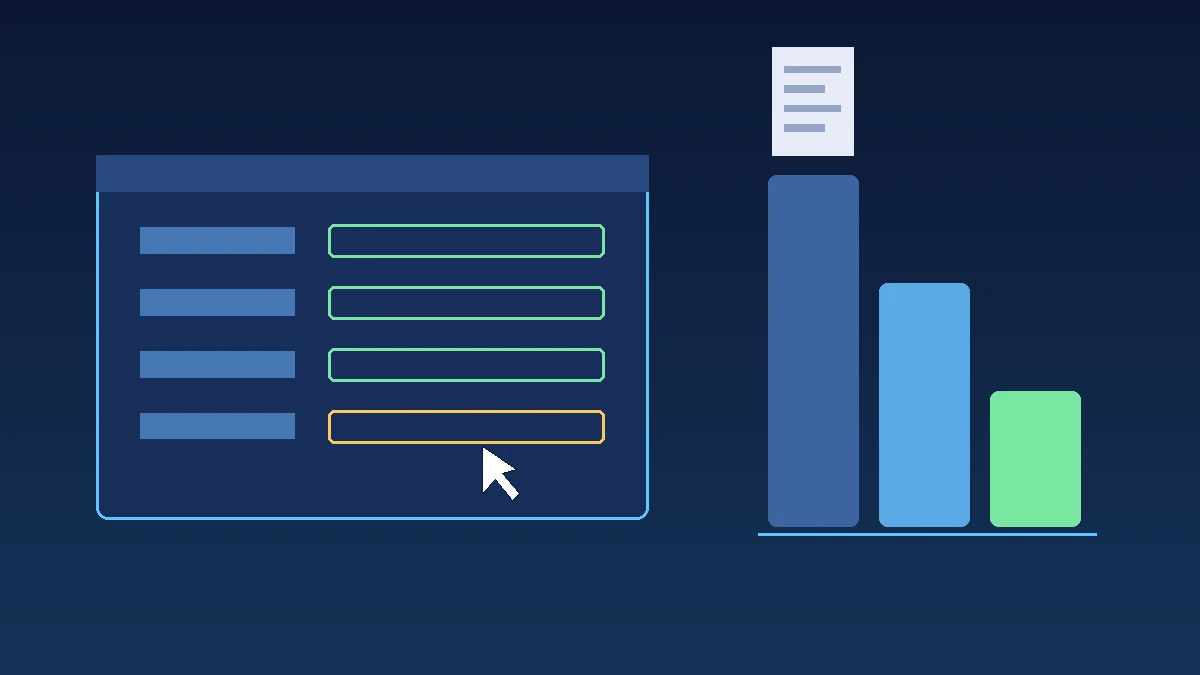
לפי The Next Web, שימוש במחשב פירושו שהדגם מסתכל על מסך, מבין מה מוצג בו ופועל: לוחץ, מקליד ועובר בין אפליקציות. הדוגמה של OpenAI היא זרם של חשבוניות נכנסות שהדגם קורא ומזין את פרטיהן לתוכנת הנהלת חשבונות.
המדדים של OpenAI
ב-Agents' Last Exam, מבחן משימות מקצועיות שכולל הפיכת שרטוטים אדריכליים למודל תלת ממדי, OpenAI מדווחת שברמת חשיבה בינונית הדגם מקבל ציון גבוה ב-15 נקודות אחוז מ-GPT‑5.6 Terra בכשליש מהעלות. לדבריה, הוא מגיע לביצועים דומים ל-GPT‑6 Astra בעשירית מהמחיר לטוקן, והוא משלים משימות מהר בלמעלה משלושה מונים מ-Astra ומ-GPT‑6.1 Sol.
בהשוואה ל-Claude Opus 5.5 של Anthropic, OpenAI כותבת שברמת מאמץ מרבית Terra יעיל בטוקנים פי שלושה ויותר ומחירו לטוקן רבע, וכתוצאה עלות המשימה נמוכה בערך פי תשעה. The Next Web מציין שהתוצאות הללו מבדיקות של OpenAI עצמה ולא נבדקו באופן עצמאי.
במבחן שאלות שנועדו לגרום לשגיאות, שיעור השגיאות ברמת חשיבה נמוכה ירד, לפי OpenAI, מ-53.6% ב-GPT‑5.6 Terra ל-16.7%, ובמאמץ מרבי ירד ב-18 נקודות אחוז ל-4.3%. ב-Terminal‑Bench 4.0, מבחן סוכני קוד בשורת הפקודה, הדגם פותר 50.3% מהמשימות במאמץ מרבי, יותר מכפול מהציון שפורסם ל-GPT‑5.6 Terra, 21.5%. OpenAI ממליצה להמשיך להשתמש ב-Sol או ב-Astra למשימות הקוד המורכבות ביותר.
ב-MMMU‑Pro, מבחן הנמקה חזותית, OpenAI מדווחת שהדגם עולה על GPT‑5.6 Terra בכל רמות החשיבה וכמעט משתווה ל-Astra ול-Sol בעלות נמוכה בהרבה. ב-OSWorld 2.1, מבחן לשימוש באפליקציות שולחן עבודה, הוא עובר ברמת חשיבה בינונית את הציון הטוב ביותר של GPT‑5.6 Terra בשבריר מהעלות למשימה. ב-Terminal‑Bench‑Science 0.1 הוא עובר את Sol במאמץ מרבי בעלות נמוכה יותר, ובמרחק של עד חמש נקודות מ-Opus 5.5 בפחות מחמישית מהעלות המוערכת, לפי OpenAI.
מחיר וזמינות
לפי OpenAI, הדגם זמין מ-26 באוקטובר למנויי Plus, Pro, Enterprise ו-Edu ב-ChatGPT Work וב-Codex, ולמפתחים ב-API בשם gpt‑6.1‑terra. המחיר הרגיל הוא $1 למיליון טוקני קלט, $0.05 למיליון טוקני קלט שמור ו-$5 למיליון טוקני פלט, והיא מציינת שהוא נמוך ב-50% מהמחיר של GPT‑5.6 Terra ושל GPT‑6.1 Sol.
The Register מפרט את המחירים בסדרה: GPT‑6 Luna ב-$0.10 ו-$0.50 למיליון טוקנים, Terra ב-$1 ו-$5, Sol ב-$2 ו-$10 ו-Astra ב-$10 ו-$50. לפי AWS, הדגם זמין באופן כללי ב-Amazon Bedrock, תומך בהקשר של עד מיליון טוקני קלט ומקבל טקסט ותמונות. Microsoft מדווחת שהוא זמין ב-Microsoft Foundry, ו-GitHub מדווחת שהוא זמין למנויי Copilot Pro, Pro+, Max, Business ו-Enterprise בהשקה הדרגתית. לפי Microsoft, בפריסת Global Standard המחיר הוא $1 ו-$5 למיליון טוקנים בהקשר קצר ו-$2 ו-$7.5 בהקשר ארוך, ויש גם פריסות Data Zone בארה"ב, באיחוד האירופי ובאזור אסיה-פסיפיק במחירים גבוהים מעט יותר.
לפי GitHub, מנהלי Copilot Business ו-Enterprise יכולים לשלוט בגישה לדגם דרך מדיניות הדגמים, ובברירת המחדל דגמים חדשים מופעלים אוטומטית, אלא אם המנהל כיבה את ההגדרה הגלובלית או חסם את הדגם במפורש. Microsoft מוסיפה שאפשר לכוונן את רמת החשיבה, כולל הגדרת none לקריאות רגישות לזמן תגובה, ולהתאים את אורך התשובה, ושהדגם יכול לשלוח הודעות ביניים בזמן עבודה על משימה ארוכה כשהשכבה המתזמרת תומכת בכך.
בטיחות
לפי כרטיס המערכת של OpenAI, החברה מתייחסת ל-GPT‑6.1 Terra כאל בעל יכולת ברמת Critical בסייבר וברמת High בתחום הביולוגי והכימי, ולכן הוא משתמש באותה ערכת אמצעי הגנה כמו GPT‑6.1 Sol ו-GPT‑6 Astra. בפוסט ההכרזה OpenAI כותבת גם שהדגם נוטה יותר מקודמו להישאר בגבולות המשימה ולהודיע בכנות על מגבלות, ושהוא הראה עמידות בבדיקות הזרקת הנחיות.
לפי The Register, Terra נוטה לסרב לבקשות מזיקות מעט פחות מ-Sol, ומסרב פחות ממנו לבקשות לגיטימיות. אלה ממצאים מהערכות של OpenAI ולא מבדיקה חיצונית.
הערכה מבחוץ ומה לא ידוע
The Register כותב שזו אינה פצצה, ומצטט את Artificial Analysis, אתר שעוקב אחר ביצועים ועלויות של דגמים, שלפיו Terra הוא הדגם הראשון ממשפחת Terra מאז GPT‑5.6 והוא חכם יותר בפחות משליש מהעלות. Ted Sanders, איש צוות טכני ב-OpenAI, כתב בהאקר ניוז, לפי The Register, שלדעתו Terra עדיף על Astra ועל Sol בתקשורת טכנית, דומה בראייה ובשימוש במחשב אך מהיר בהרבה, וקצת פחות טוב ברוב התחומים האחרים.
The Register מציין גם שמועד חיתוך הידע של Terra הוא 1 ביוני 2026, לעומת 30 באפריל 2026 ב-Astra ו-Sol. לפי The Next Web, כל השוואות הדגמים הן של OpenAI עצמה, והכתבה אינה כוללת בדיקה עצמאית של איכות הדגם או של העלות בפועל.
המשמעות שמעבר לכותרת
עיקר החדשות הוא שילוב של מחיר ושימוש במחשב: דגם שמסוגל לקרוא מסך ולהקליד באפליקציות, במחיר שנמוך בחצי מהדגם שקדם לו. The Register מתאר את ההשקה כדגם ביניים ולא כפצצה, ומצטט את Ted Sanders מ-OpenAI שאומר שבמרבית התחומים האחרים Terra קצת פחות טוב מ-Sol ומ-Astra. כל ההשוואות לדגמים אחרים נמדדו על ידי OpenAI.
צעד יישומי אחד
מי שמפעיל משימות חוזרות על מסמכים או טפסים, כמו קריאת חשבוניות והזנתן לתוכנת הנהלת חשבונות, יכול לבחון את Terra כחלופה זולה יותר ב-API. כדאי להריץ אותו על נתונים משלכם ולהשוות לדגם הנוכחי, כי המדדים שפורסמו הם של OpenAI.
מקורות ובדיקת עובדות
- OpenAI: Introducing GPT-6.1 Terra
- OpenAI: GPT-6.1 Terra system card
- The Register: OpenAI rolls out budget-priced mid-tier GPT-6.1 Terra
- The Next Web: OpenAI launches GPT-6.1 Terra, a cheaper model for everyday computer work
- AWS: OpenAI GPT-6.1 Terra is now generally available on Amazon Bedrock
- Microsoft: GPT-6.1 Terra now generally available in Microsoft Foundry
- GitHub Changelog: GPT-6.1 Terra in GitHub Copilot
ד״ר יניב שנהב
יועץ ארגוני בכיר ומנחה, העוסק במנהיגות, שינוי התנהגותי והטמעת בינה מלאכותית בארגונים. מביא למערכת מבט ניהולי ויישומי על חדשות הטכנולוגיה.
לפרופיל של ד״ר יניב שנהב